فرض کنید یک تابع کوچک در بخش محاسبه قیمت سبد خرید را تغییر میدهید، مثلاً منطق اعمال کد تخفیف را اصلاح میکنید. تغییر لوکال است، تست دستی همان یک سناریو را بررسی میکند و جواب میدهد، پس merge میشود. دو روز بعد مشخص میشود که همین تغییر، محاسبه مالیات در بخش دیگری از سیستم را که به همان تابع وابسته بوده خراب کرده است.
این الگو، Regression نام دارد: خرابی رفتاری که قبلاً درست کار میکرد، در اثر تغییری که ظاهراً بیربط به نظر میرسید. تست دستی معمولاً فقط همان سناریوی تغییرکرده را پوشش میدهد و نمیتواند تضمین کند که بقیه سیستم دستنخورده باقی مانده است. تست خودکار (Automated Testing) دقیقاً همین شکاف را پر میکند: مجموعهای از بررسیهای قابلتکرار که در چند ثانیه یا چند دقیقه، رفتار کل سیستم نه فقط بخش تغییرکرده را تأیید میکنند.
مثالهای کدنویسی این مقاله با Python و Pytest نوشته شدهاند، اما مفاهیم Testing و TDD مستقل از زبان هستند و در اکوسیستمهای دیگر (جاوااسکریپت با Jest، جاوا با JUnit، و غیره) هم به همین شکل کاربرد دارند.
چرا تست دستی کافی نیست؟
مشکلات اصلی تست دستی:
- غیرقابل تکرار است. هر بار باید مراحل را دستی طی کنید؛ زمانبر و مستعد خطای انسانی است.
- مقیاسپذیر نیست. با رشد پروژه، تعداد سناریوهای لازم برای بررسی بهصورت نمایی رشد میکند.
- Regression را تشخیص نمیدهد. همانطور که در مقدمه دیدیم، تست دستی معمولاً فقط سناریوی مرتبط با تغییر اخیر را پوشش میدهد.
- مستندسازی تولید نمیکند. یک مجموعه تست خوب، مشخصات رفتاری کد را ثبت میکند؛ تست دستی هیچ اثری باقی نمیگذارد.
راهحل رایج، ساختن یک هرم تست (Test Pyramid) است.
Test Pyramid
Test Pyramid یک مدل ذهنی رایج برای توزیع تستها در سه لایه است: تعداد زیادی تست واحد در پایه، تعداد متوسطی تست یکپارچگی در میانه، و تعداد کمی تست سرتاسری در راس.
| ویژگی | Unit Test | Integration Test | End-to-End Test |
|---|---|---|---|
| سرعت اجرا | بسیار سریع (میلیثانیه) | متوسط (چند صدم تا چند ثانیه) | کند (چند ثانیه تا چند دقیقه) |
| هزینه نگهداری | پایین | متوسط | بالا |
| سطح اطمینان | محدود به یک واحد | تعامل بین چند component | کل سیستم از دید کاربر |
| وابستگی به منابع خارجی | معمولاً هیچ | گاهی (دیتابیس تستی، سرویس داخلی) | معمولاً بله (شبکه، UI، دیتابیس واقعی) |
| تعداد تقریبی در یک پروژه معمولی | زیاد (صدها تا هزاران) | متوسط (دهها تا صدها) | کم (چند ده مورد، محدود به جریانهای حیاتی) |
| نقطه قوت | سرعت، دقت در تشخیص محل خطا | بررسی تعامل واقعی بین اجزا | نزدیکترین شبیهسازی به تجربه کاربر |
| نقطه ضعف | نمیتواند مشکلات یکپارچگی را ببیند | کندتر و شکنندهتر از Unit Test | کند، پرهزینه، و مستعد Flaky شدن |
نکته مهم این است که Test Pyramid یک راهنمای رایج است، نه یک قانون مطلق. برخی پروژهها بهخصوص سیستمهایی که عمدتاً روی ترکیب چند سرویس متکیاند ممکن است بهصورت آگاهانه به سمت مدل «لوزی تست» (Testing Trophy) حرکت کنند که در آن سهم Integration Testها بیشتر است. آنچه ثابت میماند، اصل زیربنایی است: تستهای سریع و ارزان باید بیشترین حجم را داشته باشند، و تستهای کند و پرهزینه باید محدود به مهمترین جریانها بمانند.
مفاهیم پایه تست نرمافزار
Unit Test (تست واحد)
کوچکترین واحد قابل تست کد معمولاً یک تابع یا متد را ایزوله از بقیه سیستم بررسی میکند. سریع اجرا میشود، به منبع خارجی وابسته نیست، و فقط یک رفتار مشخص را میسنجد.
Integration Test (تست یکپارچگی)
بررسی میکند که چند واحد یا component، وقتی در کنار هم قرار میگیرند، بهدرستی تعامل دارند. نکتهای که اغلب اشتباه فهمیده میشود: Integration Test لزوماً به معنی «تست دیتابیس» نیست. این نوع تست میتواند تعامل میان چند ماژول داخلی، یا تعامل سیستم با یک dependency واقعی (مثل یک سرویس داخلی دیگر، یک صف پیام، یا یک API خارجی) را بررسی کند دیتابیس فقط یکی از مصداقهای رایج آن است.
End-to-End Test (تست سرتاسری)
کل جریان کاربر را از ابتدا تا انتها شبیهسازی میکند؛ مثلاً ورود به سایت، افزودن به سبد خرید، و پرداخت. بیشترین اطمینان را میدهد، اما کندترین و شکنندهترین نوع تست است و باید به جریانهای حیاتی محدود شود.
Regression Testing
مجموعهای از تستها (معمولاً ترکیبی از Unit و Integration) که پس از هر تغییر اجرا میشوند تا مطمئن شوید رفتار قبلاً درست، همچنان درست است. Regression Testing یک نوع تست جداگانه نیست، بلکه هدفی است که با اجرای مکرر تستهای موجود محقق میشود.
Acceptance Testing
بررسی میکند که سیستم نیازمندیهای کسبوکار یا معیارهای پذیرش (Acceptance Criteria) تعریفشده توسط ذینفعان را برآورده میکند. معمولاً از دید کاربر یا صاحب محصول نوشته میشود و میتواند در سطح E2E یا در سطحی نزدیک به آن اجرا شود.
System Testing
کل سیستم یکپارچهشده را شامل تمام ماژولها و سرویسهای وابسته در محیطی شبیه به تولید بررسی میکند. با E2E همپوشانی مفهومی دارد؛ تفاوت اصلی در تمرکز است: System Testing بیشتر روی صحت عملکردی و غیرعملکردی کل سیستم (کارایی، پایداری) تمرکز دارد، در حالی که E2E بیشتر روی شبیهسازی جریان واقعی کاربر تأکید میکند.
Smoke Testing و Sanity Testing
Smoke Test یک بررسی سطحی و سریع پس از هر Deploy است: آیا اپلیکیشن اصلاً بالا میآید و مسیرهای بحرانی کار میکنند؟ Sanity Test مشابه است اما معمولاً پس از یک تغییر یا رفع باگ خاص، برای اطمینان از عملکرد همان بخش انجام میشود دامنهای محدودتر از Smoke Test اما هدفمندتر.
Test Double چیست؟
بخش تستهای واحد اغلب بهاشتباه فقط با «Mock» شناخته میشود، در حالی که Mock فقط یکی از انواع Test Double است اصطلاح کلی برای هر جایگزین کنترلشده بهجای یک وابستگی واقعی.
| نوع | هدف | مثال |
|---|---|---|
| Dummy | فقط برای پر کردن یک پارامتر اجباری، بدون استفاده واقعی | یک شیء خالی که فقط امضای تابع را کامل میکند |
| Stub | مقدار ثابت و از پیشتعیینشده برمیگرداند | تابعی که همیشه {"status": "ok"} برمیگرداند |
| Mock | رفتار را شبیهسازی میکند و بررسی میکند که با چه پارامترهایی و چند بار فراخوانی شده | بررسی اینکه charge() دقیقاً یکبار با مبلغ درست صدا زده شده |
| Spy | شبیه به Mock، اما معمولاً پیادهسازی واقعی را هم اجرا میکند و علاوه بر آن فراخوانیها را ثبت میکند | تابعی واقعی که علاوه بر اجرا، تعداد فراخوانی را هم ضبط میکند |
| Fake | پیادهسازی سادهشده اما کارکردی از یک وابستگی واقعی | یک دیتابیس درونحافظهای بهجای دیتابیس واقعی |
در پایتون، کتابخانه unittest.mock عمدتاً برای ساخت Mock و Stub استفاده میشود. مثال زیر یک سرویس اعلان را نشان میدهد که به یک درگاه پرداخت وابسته است. توجه کنید نام تابع با رفتار واقعی آن (اعلام موفقیت پرداخت، نه ارسال یک نوتیفیکیشن عمومی) مطابقت دارد:
from unittest.mock import Mock

def confirm_payment(payment_gateway, amount):
    result = payment_gateway.charge(amount)
    return result["status"] == "success"

def test_confirm_payment_success():
    mock_gateway = Mock()
    mock_gateway.charge.return_value = {"status": "success"}

    assert confirm_payment(mock_gateway, 100) is True
    mock_gateway.charge.assert_called_once_with(100)
در این تست هیچ درخواست واقعی به درگاه پرداخت ارسال نمیشود؛ mock_gateway هم رفتار (return_value) و هم فراخوانی (assert_called_once_with) را شبیهسازی و بررسی میکند — یعنی همزمان نقش Stub و Mock را ایفا میکند.
TDD چیست؟
Test-Driven Development رویکردی است که در آن تست پیش از کد اصلی نوشته میشود. اما TDD صرفاً «اول تست بنویس» نیست؛ نوشتن تست پیش از پیادهسازی، شما را مجبور میکند که ابتدا API و رفتار مورد انتظار تابع را از دید مصرفکننده آن طراحی کنید همین موضوع اغلب به معماری سادهتر و رابطهای تمیزتر منجر میشود.
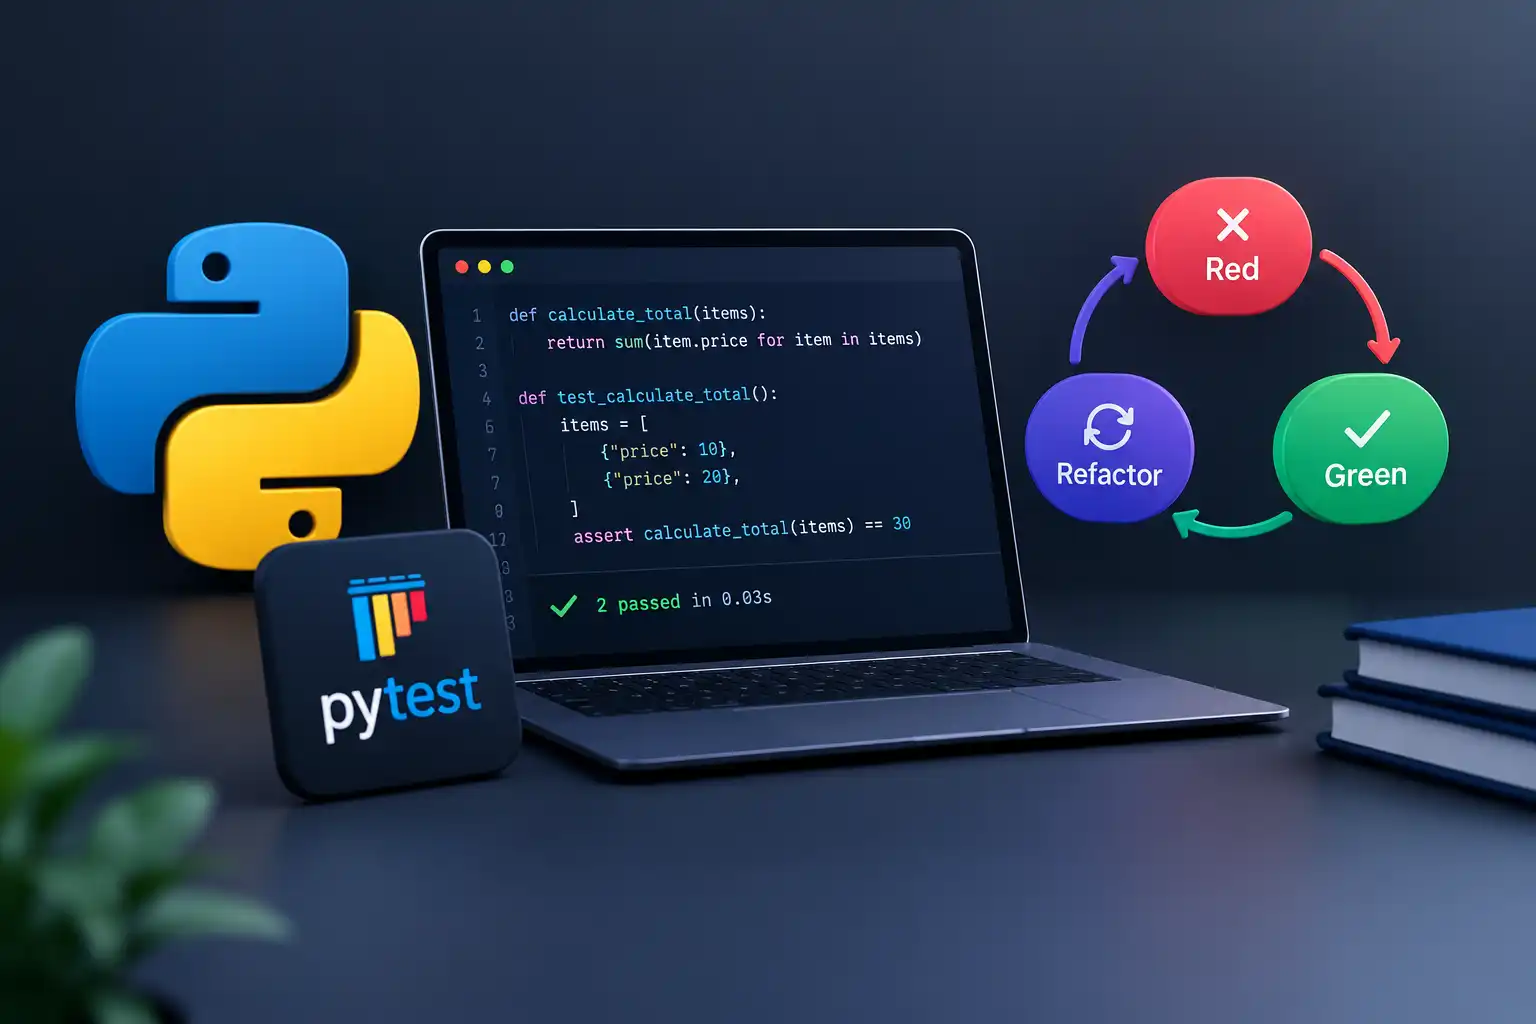
چرخه Red → Green → Refactor
- Red: ابتدا رفتار مورد انتظار را در قالب یک تست مشخص میکنیم تستی که چون کد هنوز وجود ندارد، شکست میخورد.
- Green: سادهترین پیادهسازی لازم برای عبور آن تست را مینویسیم؛ نه بیشتر.
- Refactor: ساختار داخلی کد را، بدون تغییر در رفتار مورد انتظار، بهبود میدهیم.
نکته مهمی که اغلب نادیده گرفته میشود: Refactoring با افزودن قابلیت جدید (Adding a New Feature) فرق دارد. Refactor یعنی رفتار بیرونی ثابت میماند و فقط ساختار داخلی تغییر میکند. اگر در همین مرحله قابلیتی جدید مثلاً پارامتری برای نرخ تخفیف سفارشی اضافه شود، این کار Refactor خالص نیست؛ رفتار سیستم تغییر کرده است. روش درست، شروع یک چرخه TDD جدید و مستقل است: ابتدا تستی برای رفتار جدید بنویسید (Red)، سپس کمترین کد لازم را اضافه کنید (Green)، و در پایان در صورت نیاز Refactor کنید.
پیادهسازی TDD روی یک مثال واقعی
فرض کنید تابعی برای محاسبه مبلغ تخفیف یک سفارش مینویسیم.
چرخه اول: نرخ تخفیف ثابت
Red تعریف رفتار مورد انتظار:
import pytest
from discount import calculate_discount

def test_discount_for_valid_amount():
    assert calculate_discount(100) == 10

def test_discount_for_zero_amount():
    assert calculate_discount(0) == 0

def test_discount_raises_error_for_negative_amount():
    with pytest.raises(ValueError):
        calculate_discount(-50)
در این مرحله اجرای تستها با خطا مواجه میشود چون calculate_discount هنوز وجود ندارد.
Green سادهترین پیادهسازی:
def calculate_discount(amount: float) -> float:
    if amount < 0:
        raise ValueError("Amount cannot be negative")
    return amount * 0.10
توجه کنید که شرط جداگانه برای صفر لازم نیست، چون amount * 0.10 برای amount = 0 بهطور طبیعی صفر برمیگرداند.
چرخه دوم: نرخ تخفیف سفارشی (یک قابلیت جدید، نه Refactor)
Red:
def test_discount_with_custom_rate():
    assert calculate_discount(200, rate=0.20) == 40
Green:
DEFAULT_DISCOUNT_RATE = 0.10

def calculate_discount(amount: float, rate: float = DEFAULT_DISCOUNT_RATE) -> float:
    if amount < 0:
        raise ValueError("Amount cannot be negative")
    return amount * rate
با parametrize میتوان همه سناریوها را در یک تست فشرده و خوانا جمع کرد:
@pytest.mark.parametrize(
    "amount, rate, expected",
    [
        (100, 0.10, 10),
        (0, 0.10, 0),
        (200, 0.20, 40),
        (0.01, 0.10, pytest.approx(0.001)),
    ],
)
def test_calculate_discount(amount, rate, expected):
    assert calculate_discount(amount, rate) == expected

def test_calculate_discount_raises_for_negative_amount():
    with pytest.raises(ValueError):
        calculate_discount(-50)
نکته فنی مهم: در این مثال از float برای مبلغ استفاده شده که برای آموزش مناسب است، اما در محاسبات مالی واقعی، float میتواند خطای دقت (precision error) تولید کند — مثلاً 0.1 + 0.2 در پایتون دقیقاً برابر 0.3 نیست. برای پروژههای واقعی مالی، استفاده از نوع Decimal (از ماژول decimal) یا کار با کوچکترین واحد پول (مثلاً سنت بهجای دلار در قالب عدد صحیح) توصیه میشود.
نوشتن تست API
Integration Test برای یک API معمولاً از یک کلاینت تست استفاده میکند که درخواست HTTP را شبیهسازی میکند، بدون بالا آوردن سرور واقعی. مثال زیر با Flask و Pytest چند حالت رایج را پوشش میدهد:
import pytest
from app import create_app
@pytest.fixture
def client():
app = create_app(testing=True)
with app.test_client() as client:
yield client
def test_create_order_success(client):
payload = {"product_id": 1, "quantity": 2}
response = client.post("/orders", json=payload)
assert response.status_code == 201
assert response.json["quantity"] == 2
def test_create_order_missing_field_returns_400(client):
response = client.post("/orders", json={"quantity": 2}) # product_id گمشده
assert response.status_code == 400
assert "product_id" in response.json["error"]
def test_create_order_unauthorized_without_token(client):
response = client.post("/orders", json={"product_id": 1, "quantity": 1})
assert response.status_code == 401
def test_create_order_forbidden_for_readonly_role(client, readonly_token):
headers = {"Authorization": f"Bearer {readonly_token}"}
response = client.post("/orders", json={"product_id": 1, "quantity": 1}, headers=headers)
assert response.status_code == 403
def test_get_order_not_found(client):
response = client.get("/orders/9999")
assert response.status_code == 404
def test_create_order_invalid_quantity_type(client):
response = client.post("/orders", json={"product_id": 1, "quantity": "two"})
assert response.status_code == 400هر تست دقیقاً یک ترکیب از Status Code و Response Body را بررسی میکند: موفقیت (۲۰۱)، خطای اعتبارسنجی (۴۰۰ برای فیلد گمشده یا نوع داده نامعتبر)، عدم احراز هویت (۴۰۱)، عدم دسترسی (۴۰۳)، و منبع یافتنشده (۴۰۴). همانطور که پیشتر اشاره شد، این نوع تست لزوماً به دیتابیس واقعی وابسته نیست؛ create_app(testing=True) میتواند از یک پیکربندی سبکتر یا دیتابیس درونحافظهای استفاده کند و همچنان یک Integration Test معتبر باشد، چون تعامل واقعی بین routing، اعتبارسنجی، و منطق کسبوکار را میسنجد.
Fixtures و Test Data
اگر به مثال بالا دقت کنید، تابع client با دکوراتور @pytest.fixture تعریف شده است. Fixture مشکل تکرار کد راهاندازی (setup) در ابتدای هر تست را حل میکند: بهجای اینکه در هر تابع تست، اپلیکیشن را از نو بسازید، Fixture یکبار آن را میسازد و به هر تستی که نامش را بهعنوان پارامتر بگیرد، تزریق میکند.
@pytest.fixture
def sample_order():
    return {"product_id": 1, "quantity": 2, "price": 49.99}

def test_order_total_price(sample_order):
    assert sample_order["price"] * sample_order["quantity"] == 99.98
Fixtureها همچنین میتوانند منطق پاکسازی (teardown) داشته باشند با استفاده از yield بهجای return که برای مواردی مثل بستن اتصال دیتابیس تستی یا حذف فایلهای موقت کاربرد دارد.
طراحی پروژه قابل تست
نوشتن تست خوب کافی نیست؛ ساختار کد هم باید تستپذیری را پشتیبانی کند.
Dependency Injection. وقتی وابستگی درون تابع ساخته میشود، جایگزینی آن با نسخه تستی دشوار است:
# سخت برای تست: اتصال دیتابیس درون تابع ساخته میشود
def get_user_data(user_id):
db = connect_to_database()
return db.query(user_id)
# ساده برای تست: وابستگی از بیرون تزریق میشود
def get_user_data(user_id, db):
return db.query(user_id)در نسخه دوم، در تست کافی است یک Fake یا Mock بهجای db واقعی پاس داده شود.
Pure Functions. تابعی که فقط بر اساس ورودیهایش خروجی تولید میکند و هیچ عارضه جانبی ندارد، سادهترین نوع تابع برای تست است:
def apply_tax(price: float, tax_rate: float) -> float:
    return price * (1 + tax_rate)
هیچ Mock یا Fixtureای برای تست این تابع لازم نیست.
Separation of Concerns و Side Effects. منطق کسبوکار (مثل محاسبه قیمت) را از عملیات وابسته به دیتابیس، شبکه، فایلسیستم یا API خارجی جدا کنید. وقتی محاسبه از عارضه جانبی جدا باشد، میتوانید منطق را با Unit Test سریع بسنجید و فقط لایه نازک اتصال به منابع خارجی را با Integration Test پوشش دهید.
Single Responsibility. تابعی که فقط یک کار انجام میدهد، هم تستنویسی سادهتری دارد و هم اسم تستها گویاتر میشود؛ برخلاف توابع بزرگ که برای پوشش کامل به دهها سناریوی ترکیبی نیاز دارند.
Interface / Abstraction. در پروژههای بزرگتر، تعریف یک قرارداد مشخص برای وابستگیها (مثلاً یک Interface برای PaymentGateway) اجازه میدهد در تست از یک Fake ساده و در تولید از پیادهسازی واقعی استفاده کنید، بدون تغییر در کدی که از آن قرارداد استفاده میکند.
Flaky Test ها
تست Flaky تستی است که بدون هیچ تغییری در کد، گاهی Pass و گاهی Fail میشود. Flaky Testها یکی از بزرگترین منابع بیاعتمادی تیمها به مجموعه تست است؛ وقتی یک تست گاهی بدون دلیل Fail میشود، توسعهدهندهها بهمرور یاد میگیرند شکستها را نادیده بگیرند — که خطرناک است.
علل رایج:
- Timing: تستی که فرض میکند یک عملیات Async در بازه زمانی مشخصی تمام میشود.
- Concurrency: ترتیب اجرای Threadها یا Taskها قطعی نیست.
- Network: وابستگی به یک سرویس خارجی واقعی که ممکن است کند یا در دسترس نباشد.
- Shared State: تستهایی که روی داده مشترک (مثل یک فایل یا رکورد دیتابیس مشترک) کار میکنند و به ترتیب اجرا وابستهاند.
- Test Order: تستی که فرض میکند تست دیگری پیش از آن اجرا شده است.
- Date/Time Dependency: تستی که به تاریخ یا ساعت لحظه اجرا وابسته است.
- External Services: وابستگی مستقیم به API یا سرویس بیرونی واقعی بهجای Fake یا Mock.
راهکارهای عملی: ایزوله کردن هر تست (بدون وابستگی به state تست دیگر)، استفاده از Mock/Fake بهجای سرویسهای خارجی واقعی، ثابت کردن زمان با ابزارهایی مثل freezegun، و اجرای مکرر تستهای مشکوک در CI برای شناسایی الگوی Flaky بودن پیش از اینکه به شکستهای تصادفی در Pipeline اصلی تبدیل شوند.
Code Coverage و Mutation Testing
Code Coverage نشان میدهد چه بخشی از کد در حین اجرای تستها لمس شده است. دو معیار رایج:
- Line Coverage: چند درصد از خطوط کد حداقل یکبار اجرا شدهاند.
- Branch Coverage: چند درصد از مسیرهای شرطی (هر دو حالت if/else) پوشش داده شدهاند معیار دقیقتری نسبت به Line Coverage.
نکته کلیدی: ۱۰۰٪ Coverage به معنی ۱۰۰٪ کیفیت نیست. میتوان تستی نوشت که خط را اجرا میکند اما هیچ ادعای معناداری بررسی نمیکند:
def test_calculate_discount_runs_without_error():
calculate_discount(100)
assert True # هیچ رفتاری واقعاً بررسی نمیشوداین تست، Coverage را بالا میبرد بدون آنکه هیچ باگی را بگیرد. اینجاست که Mutation Testing به کمک میآید: ابزار Mutation Testing بهصورت خودکار تغییرات کوچک و عمدی (Mutation) در کد ایجاد میکند — مثلاً < را به <= تبدیل میکند یا یک عدد ثابت را تغییر میدهد — و بررسی میکند آیا مجموعه تستهای موجود این تغییر را میگیرد (تست Fail میشود) یا نه. اگر تستی بدون ایجاد شکست از کنار یک Mutation عبور کند، یعنی آن تست عملاً چیزی را تضمین نمیکند، حتی اگر در گزارش Coverage بهعنوان «پوشش دادهشده» ثبت شده باشد. برای پایتون، ابزارهایی مانند mutmut این کار را انجام میدهند؛ ورود به جزئیات پیکربندی آنها خارج از هدف این مقاله است.
تست در CI/CD
اجرای دستی تستها پیش از هر Merge، بهمرور فراموش یا نادیده گرفته میشود. راهحل رایج، اجرای خودکار تستها در Pipeline CI/CD است:
Developer → Commit → Pull Request → CI
→ Unit Tests → Integration Tests → Build → Deploy
اگر هر مرحله Fail شود، مرحله بعدی اجرا نمیشود — یعنی کدی که تستهای واحد یا یکپارچگی را رد نکرده، هرگز به مرحله Build یا Deploy نمیرسد. این کار Regression را در همان لحظه Pull Request شناسایی میکند، نه پس از استقرار در تولید.
نمونه ساده یک Workflow در GitHub Actions برای اجرای Pytest:
name: Run Tests

on:
  pull_request:
    branches: [main]

jobs:
  test:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - uses: actions/setup-python@v5
        with:
          python-version: "3.12"
      - name: Install dependencies
        run: pip install -r requirements.txt
      - name: Run tests
        run: pytest --maxfail=1 -v
این Workflow روی هر Pull Request به شاخه main اجرا میشود و در صورت شکست هر تست، جلوی Merge را میگیرد.
جمعبندی
چند اصل عملی برای بهکارگیری در پروژههای واقعی:
- همهچیز را با E2E تست نکنید؛ سرعت و هزینه نگهداری اهمیت دارد.
- تا حد ممکن منطق کسبوکار را با Unit Test پوشش دهید — سریعترین و ارزانترین بازخورد را میدهد.
- از Integration Test برای تعامل واقعی بین componentها استفاده کنید، نه صرفاً برای «تست دیتابیس».
- End-to-End2 Test را فقط برای جریانهای واقعاً حیاتی نگه دارید.
- Coverage را هدف نهایی قرار ندهید؛ یک تست بیمعنا میتواند Coverage را بالا ببرد بدون آنکه واقعاً چیزی را بسنجد.
- Testability را از همان لحظه طراحی کد در نظر بگیرید با Dependency Injection، توابع خالص و جداسازی Side Effectها.
- تستها را در CI اجرا کنید تا Regression پیش از Deploy شناسایی شود.
- تستهای Flaky را جدی بگیرید؛ نادیده گرفتن آنها اعتماد تیم به کل مجموعه تست را از بین میبرد.
- در نهایت، هر تست باید یک ادعای مشخص درباره رفتار مورد انتظار بسنجد نه صرفاً اجرای بدون خطای کد.
نظرات کاربران
هنوز نظری ثبت نشده است. اولین نفری باشید که نظر خود را مینویسد!